这是一个 SasaDaily 假设案例。
不是 Anthropic 公布的真实客户成效。
假设有一家:
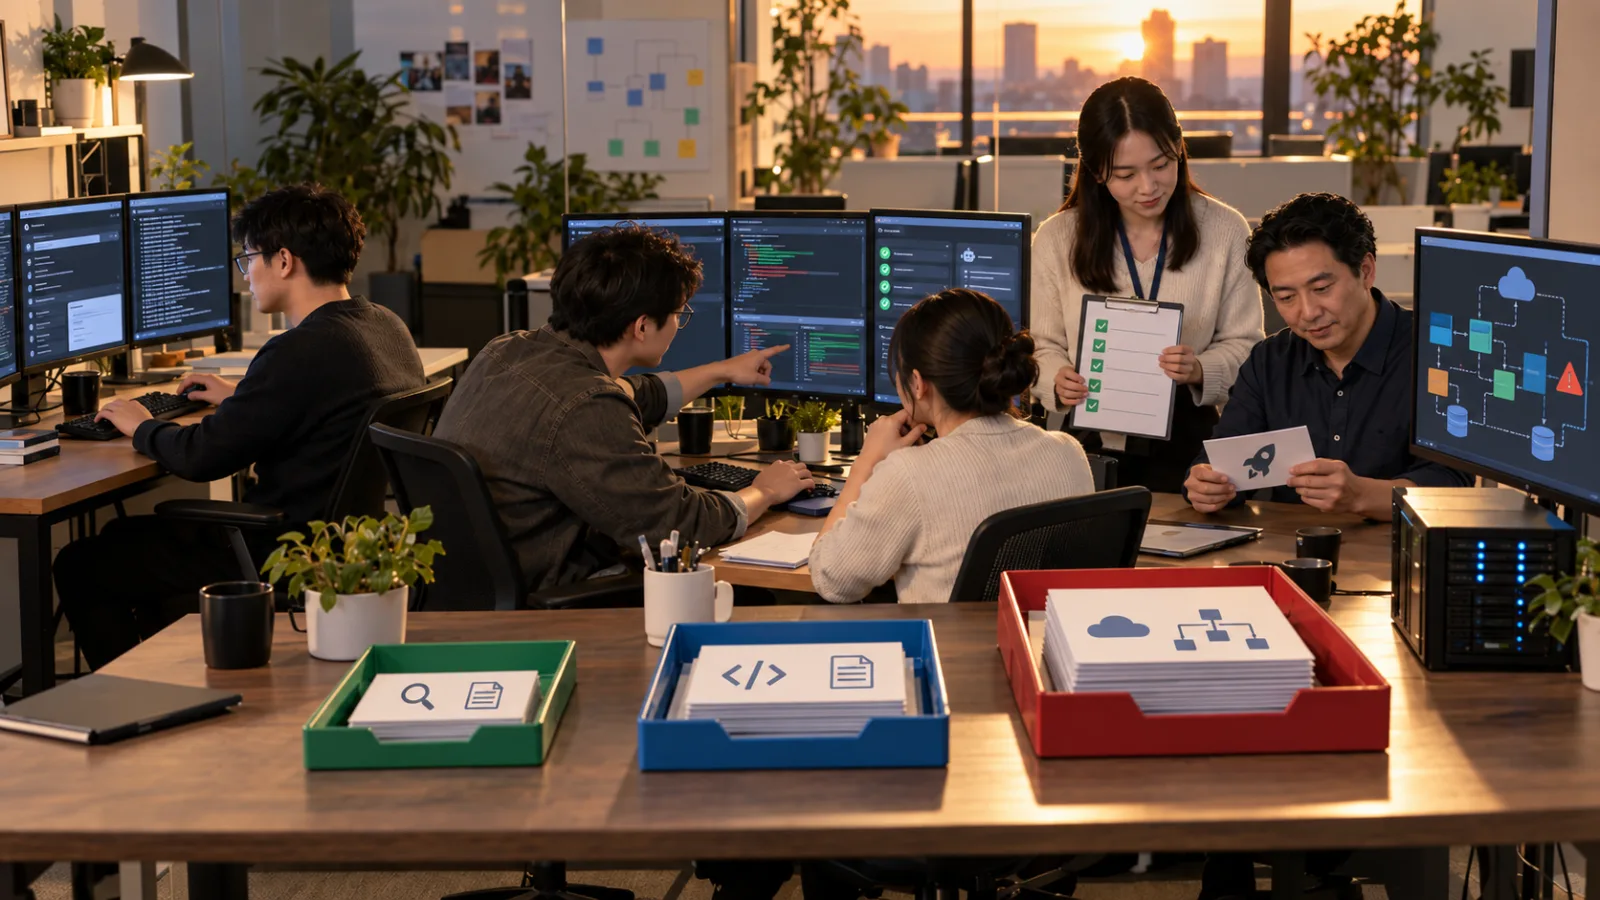
5 人软件维护工作室。
平常替几家中小企业维护:
官网。
会员系统。
后台。
API。
内部工具。
每星期进来的工作非常杂。
可能是:
找一个 Error Log。
改一个字段。
修一个 Bug。
加一个小功能。
做 Code Review。
也可能突然出现:
跨 API、Frontend、Database 的大型问题。
如果全部工作一进来就直接使用:
最贵、最强的模型,
确实很简单。
但月底很容易发现:
AI 做得很快,帐也长得很快。
这家公司真正要管理的不是「要不要用 AI」
AI Coding 已经是日常工具。
真正的问题变成:
哪一件工作,值得用哪一级模型?
所以团队不再规定:
「全部用最强模型。」
而是先把工作拆成三层。
第一层:查找型工作
例如:
搜索 Function 在哪里。
读 Log。
找 Error Code。
查某个 Package 文档。
列出哪些 Files 引用了某个名称。
这类任务主要需要:
找到东西。
不一定需要最强的推理。
因此先交给:
较便宜的小模型
或专门的 Search Subagent。
第二层:真正的日常开发
例如:
修一个 Bug。
修改几个互相相关的 Files。
增加小功能。
Code Review。
依照既有 Pattern 修改 API。
这一层预设使用:
Claude Opus 5.5。
第三层:真正卡住的工作
例如:
跨多个 Service 的 Architecture Problem。
没有既有 Pattern。
需要长时间无人监督。
牵涉多个 Subagents。
或者:
Opus 5.5 High 已经在同一问题失败两次。
这时才升级:
Claude Fable 5.1。
真正的规则不是:
「最难模型优先。」
而是:
「刚好够用的模型优先。」
早上第一张 Ticket:只是查 Log
例如客户回报:
「昨天晚上付款页偶尔出现 Error。」
工程师第一件事不是叫 Fable 5.1:
「把整个系统查一遍。」
而是先让便宜模型处理:
昨天特定时段 Log。
找出:
Error Pattern。
出现次数。
相关 Endpoint。
可能牵涉的 File。
最后只回给主工程师:
真正需要看的 3~5 个位置。
如果只是:
第三方 API Timeout,
甚至可能不需要高级模型介入。
为什么查 Log 不要一开始就用 Opus?
不是因为 Opus 做不到。
而是:
这一步真正的 Bottleneck
不是:
复杂 Reasoning。
而是:
大量阅读+搜索。
Anthropic 对 Claude Code 的成本建议也很明确:
Search。
Lookup。
Log Reading
这类 Subagent,
可以考虑较便宜模型。
真正需要:
Code Editing。
Debugging。
Feature Work
再交给 Opus 5.5。
这就是:
Model Routing。
第二张 Ticket:客户要添加一个小功能
例如客户说:
「后台订单页添加一个『待人工确认』状态。」
这就不是单纯 Search。
可能同时要改:
Database Enum。
Backend Validation。
API Response。
Frontend Badge。
Tests。
团队把它交给:
Opus 5.5 Medium。
先让模型:
找全部相关 Call Sites。
整理修改范围。
再一次修改。
跑 Test。
为什么先用 Medium?
Anthropic 对 Opus 5.5 的建议是:
日常、
范围清楚、
有人监督的工作,
Medium 通常是一个合理起点。
因为工程师正在旁边看。
如果 Claude:
跑错方向。
漏一层。
工程师可以立刻介入。
不需要每一件工作都先支付:
最高 Effort
的 Thinking Cost。
但「省 Thinking」不是最高目标
假设 Medium 修改完:
Backend Test 通过。
工程师却发现:
Frontend 还在送旧 Field。
这时有两种可能。
第一种:
只是没有一个完整 End-to-end Test。
那就先补:
Validation。
Test。
第二种:
模型确实没有往更深的 Dependency 找。
这时再把:
Effort
提升到:
High。
不要第一秒就:
换 Fable。
Anthropic 自己也提醒:Retry 很贵
因为 AI Agent 工作不是一次 Request。
而是一个 Loop。
看 Code。
↓
用 Tool。
↓
看结果。
↓
再修改。
↓
再跑 Test。
每多一轮,
前面的 Context
还要再跟着送一次。
所以:
「便宜做错三次」
可能比:
「稍微多想一次直接做完」
更贵。
团队真正追踪的是:
完成这一张 Ticket 花多少。
不是:
某一次 Request 有多便宜。
第三张 Ticket:大型跨系统 Bug
假设问题变成:
会员续约后,
Payment Service 已成功扣款,
但:
CRM 状态没有更新。
Email 又重复寄两次。
这时可能牵涉:
Payment Webhook。
Queue。
Database Transaction。
CRM Integration。
Email Worker。
Retry Logic。
工程师先让:
Opus 5.5 High
处理。
如果:
第一次找到部分问题。
修完仍失败。
第二次又卡在:
相同 Root Cause,
这家公司设置一条很简单的规则:
不要再跑第三次。
直接升级:
Fable 5.1。
为什么设置「两次」?
这不是 Anthropic 的硬性技术限制。
而是一个 Workflow Rule。
Anthropic 自己在 Opus 5.5 成本指南中也提出类似建议:
如果 Opus 5.5 High
在同一问题:
卡两次,
就升级更强模型。
问题解掉后:
再切回 Opus 5.5。
原因很简单。
最贵的不一定是:
高价模型。
有时候真正最贵的是:
一直让不适合的模型重试。
解掉最难的部分后,不要整个 Project 都留在 Fable
例如 Fable 5.1 最后发现:
Queue Retry
和:
Webhook Idempotency
互相冲突。
Root Cause 已经找到了。
接下来只是:
修改三个 Files。
补 Tests。
整理 PR。
那就可以:
切回 Opus 5.5。
不要因为:
Fable 解掉一个难题,
接下来所有:
Rename。
Tests。
Documentation。
都继续用最贵模型。
这就是这家公司最内核的:
Escalate → Solve → Step Down。
QA 也不再只问「AI 说完成了吗?」
模型完成修改之后,
一定要有:
真正可以验证的东西。
例如:
Unit Tests。
Integration Tests。
Build。
Lint。
API Test。
这家公司规定:
没有 Test Evidence,
不进:
Human Review。
因为:
AI 自己说:
Done
不是 Verification。
AI 能自己跑 Test,反而可能更省钱
看起来:
多跑一次 Test
也是 Token。
也是 Turn。
但如果 Test 能在模型第一次改错时:
立刻 Fail,
它可以当场修正。
比起:
AI 说完成。
人工隔天才发现错。
重新开 Session。
重新加载 Context。
重新解释一次。
通常更划算。
所以:
Verification 本身不是浪费。
没有 Verification 造成的:
重做
才可能更贵。
最后一道线:Merge 还是由人决定
即使:
Opus 5.5 Code Review 没找到问题。
Tests 全绿。
QA 也通过。
这家公司仍然不让 AI:
自动 Merge Production Branch。
工程师必须确认:
实际改了哪些 Files?
是不是超出原 Ticket Scope?
Migration 有没有风险?
Rollback 怎么做?
客户原本要求的功能有没有被偷偷扩大?
最后:
Human Merge。
Production Deploy 也不交给模型自行决定
Deploy 前还要确认:
Backup。
Migration Window。
Environment。
Monitoring。
Rollback。
客户可接受的 Downtime。
因为:
代码正确
和:
现在适合上 Production
是两个不同问题。
AI 可以协助:
创建 Deployment Checklist。
整理 Change Summary。
产生 Rollback Draft。
但:
真正按下 Deploy
仍然要由人批准。
这家公司每天真正看的不是 Token Price
每张 Ticket 完成后,
团队只记几个东西:
用了哪个 Model。
Effort。
跑几个 Turns。
有没有 Retry。
Human Review 花多久。
最后一次是否通过。
以及:
整件工作的 Estimated Cost。
真正 KPI 是:
Cost per Completed Ticket。
不是:
Cost per Million Tokens。
假设一星期有 30 张 Ticket
以下只是:
SasaDaily 假设测算。
假设工作室一周收到:
30 张技术工作。
其中:
12 张是 Search/Log/Lookup。
14 张是一般 Bug/Feature/Review。
4 张比较复杂。
如果以前做法是:
30 张全部直接使用最高级模型,
Model Cost 先假设:
每周约 150 美元。
现在改成:
12 张简单任务先走低成本模型。
14 张使用 Opus 5.5。
4 张先 Opus 5.5 High。
真正解不掉的少数问题才升 Fable。
假设最后每周 AI Usage Cost:
降到:
95 美元。
单看 AI 成本:
每周少:
55 美元。
四周约:
220 美元。
这全部都是:
示范算式。
不是 Anthropic 客户成效。
但如果工程师 Review 变久,220 美元根本不重要
假设便宜模型让:
每周多出 5 小时人工修错。
就算 AI 少花:
220 美元,
整体也可能:
更贵。
所以这家公司另外记:
Human Review Time。
例如导入前:
每张平均 Review:
20 分钟。
导入后:
15 分钟。
那才是真的改善。
如果变成:
30 分钟,
就代表:
Model Routing
切得太低。
最容易犯的错就是:为了省 AI 成本,把成本转嫁给工程师
AI 帐单非常容易看。
工程师时间却常被忽略。
例如:
小模型便宜 0.50 美元。
但 Senior Engineer
多花 20 分钟:
修它。
那 0.50 美元的节省,
几乎没有意义。
因此这家公司最后比较的是:
AI Cost
+
Human Review Time
+
Retry
+
Failure Risk。
这才是完整 ROI。
Opus 5.5 为什么适合放在中间?
Anthropic 对 Opus 5.5 的定位,
本来就很接近这一层。
官方表示:
Input/Output Token Price
比 Opus 5 低:
20%。
Cache Read
低:
60%。
而 Typical Workloads
估计总成本约降低:
40%。
同时,
Anthropic 建议将它作为:
有人监督的日常 Feature Work、
Debugging
与:
Code Review
主力模型。
所以它不是:
最便宜模型。
也不是:
所有情况都应该用的最高级模型。
比较像:
日常主力。
Fable 5.1 则是「问题比 Token Price 重要」时才上
例如:
周末 Migration。
大型架构重构。
数小时无人监督。
多个 Subagents。
非常陌生的问题。
这种时候:
工程失败的成本
可能远高于:
Model Cost。
这时才值得:
付更多钱。
这和一般公司用人其实很像。
不是每一张单据:
都交给公司最资深的人处理。
但真正的重大例外:
要能快速升级。
团队甚至可以每周只检查一次「升级案例」
星期五只看:
哪些 Ticket 从 Opus 升 Fable?
原因是什么?
如果一星期 30 张里:
20 张都升级,
那不是:
「Fable 很强。」
而可能代表:
Opus 5.5 根本不适合这批工作。
或者:
Task Scope 写得太差。
Tests 不完整。
Context 不够。
Workflow 本身有问题。
相反地,
如果整个月一次都没有升级,
也可以问:
是不是:
根本没有必要保留这么昂贵的 Escalation Path?
最小导入方式不是一次改整个工程团队
如果小公司现在已经在用 Claude Code,
不要第一天就创建:
复杂 Router。
Dashboard。
自动 Cost Allocation。
最小测试可以只有:
一周。
挑三类 Task:
Search。
Daily Coding。
Hard Problem。
先规定:
Search → 小模型。
Daily → Opus 5.5 Medium。
Hard → Opus 5.5 High。
High 同题失败两次:
→ Fable 5.1。
然后记:
完成率。
Turns。
Retry。
Review Time。
Estimated Cost。
一周之后再决定:
这套分工到底有没有价值。
这个案例真正省的不是「模型变便宜」
Claude Opus 5.5 本身的确降价。
但如果公司依然:
所有工作都用同一模型。
所有 Task 都开最高 Effort。
失败就一直 Retry。
Search 也用最高级模型。
没有 Test。
没有 Human Gate。
那:
模型便宜 20%,
只是让一个原本不合理的 Workflow:
便宜一点继续跑。
真正的改善是:
把工作分级。
简单工作:
不要过度配置。
正常工作:
用主力模型。
难题:
快速升级。
做完:
再降回来。
AI 真正进入企业之后,
成本管理最后会愈来愈像:
人力配置。
不是:
「谁最强就全部给谁做。」
而是:
「什么工作,需要什么能力才刚好。」
如果你也想知道自己的工作里,哪一步最适合先交给 AI,留言「流程」。
今天,和 AI 一起进步一点。
每天学会一个 AI 技巧。
每天节省一点时间。
每天提升一点能力。
SasaDaily,陪你一起成长。
推荐阅读
AI 商业案例|2026/09/07:5 人网站维护团队怎么用 Qwen Code?项目规则分开记、多个 Agent 分工,正式上线仍由人批准
AI 商业案例|2026/09/18:7 人软件集成公司怎么用 Claude Code Projects?API/Web/Mobile 平行改版,共享规格变更,Merge/Deploy 仍由人批准
AI 商业案例|2026/09/11:6 人 SaaS 团队怎么用 Qodo?Coding Agent 改完先独立 Review,Production 决策仍由人批准