一家 5 人市场情报工作室,
每天固定要追:
竞品官网、
价格页、
Release Notes、
官方 Blog、
公开产业数据。
以前最麻烦的不是「看不懂」。
而是:
每天都要重新打开同一批网站,看今天到底有没有变。
所以团队很自然会想到:
「干脆叫 AI Agent 每天全部帮我查。」
这个方向没有错。
问题是,
如果你的指令只有:
「把这 20 个网站全部追完,有变化就告诉我。」
你其实只定义了:
任务什么时候算成功。
却没有定义:
Agent 为了完成任务,
到底可以对外部网站做多少事。
今天这个案例,
只示范一个更安全的做法:
来源 → 请求上限 → 超量就停。
这是一个 SasaDaily 假设案例
先说清楚:
以下 5 人团队、
20 个网站、
Request Budget
都是为了示范工作流程而设置的假设案例。
不是某家公司已经实际导入后公布的客户成果,
也不代表照做一定可以省下多少工时。
真正的 Proof,
来自最近 Wikimedia 公开的一个真实事件。
后面会讲。
团队原本每天在做什么?
假设这是一家替 B2B 客户做市场情报的小型工作室。
5 个人每天要追 20 个固定来源。
包括:
5 家竞品产品页,
5 家竞品 Pricing Page,
5 个 Release Notes/官方 Blog,
以及 5 个政府或产业公开数据源。
真正需要的不是:
每天重读所有内容。
而只是知道:
「昨天到今天,哪里变了?」
例如:
价格改了。
方案名称改了。
推出新功能。
API 条款改了。
停止某项服务。
监管机关多了一份公告。
这些才值得分析师花时间。
AI 最适合先接哪一步?
不是:
「AI 帮我做完整市场策略。」
先接最重复的第一步:
定时检查既定来源,找出变更。
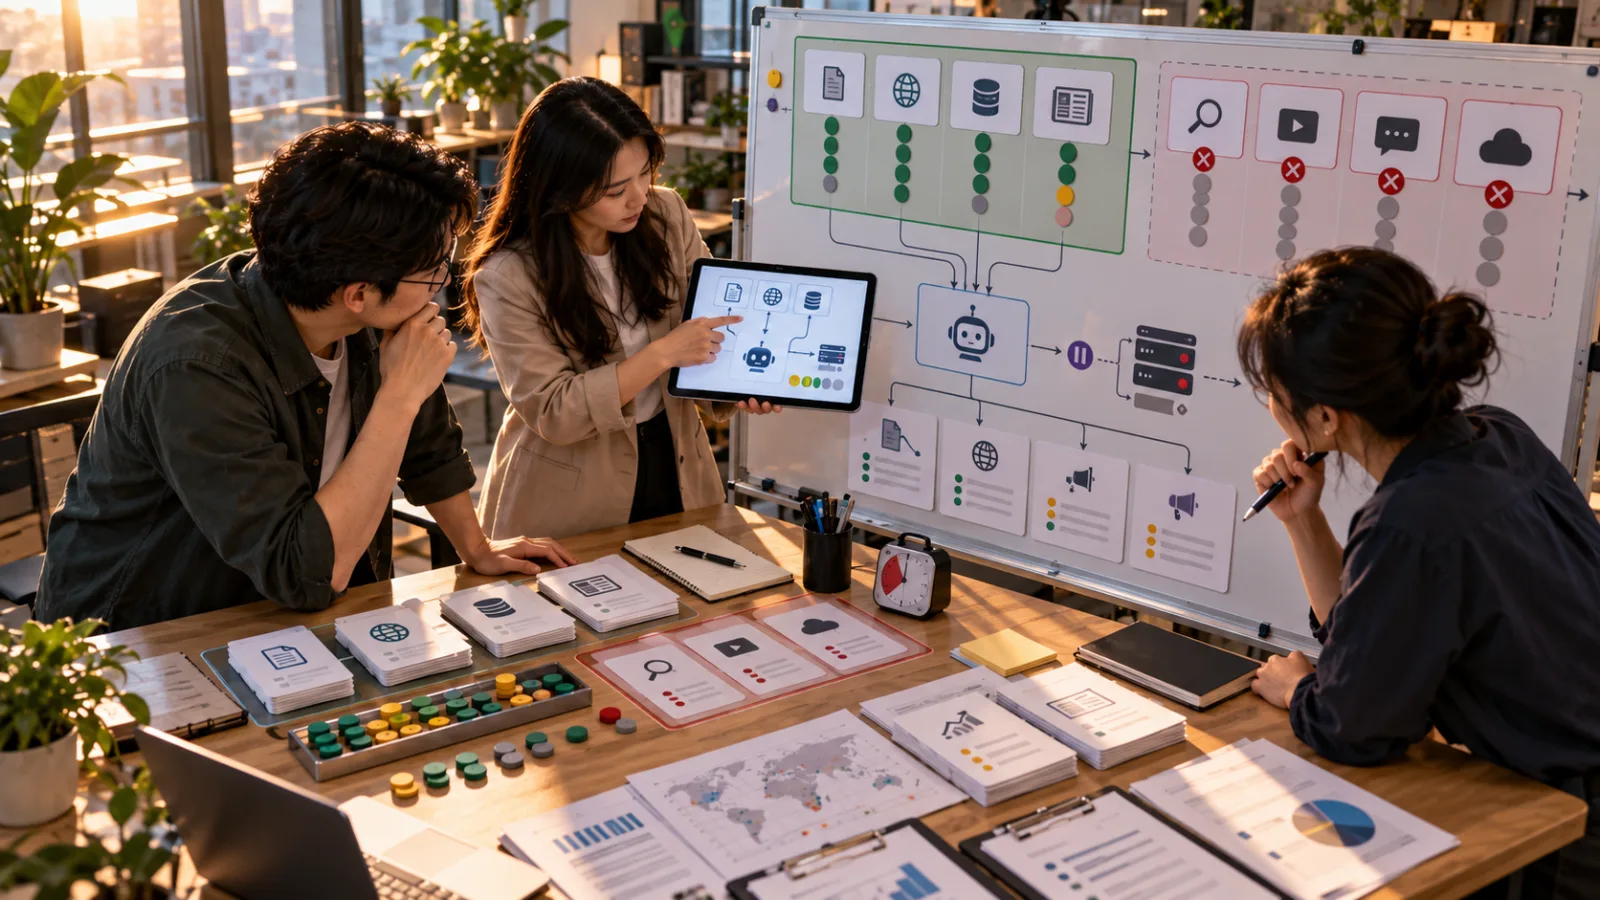
理想流程可以是:
固定来源 →
读取最新版本 →
和上次 Snapshot 比对 →
只留下真正变更 →
产生一份 Change Digest →
人再判断哪些值得追。
这就是 AI 很适合做的:
高频、
重复、
可以验证。
但真正容易漏掉的是:
Agent 怎么取得那些数据。
第一层:来源不能让 Agent 自己无限扩张
如果任务是:
追 20 个固定来源,
那就先创建:
Source Allowlist。
只有这 20 个来源可以进入每日监控。
不要一开始就叫:
「看到相关链接也自己继续研究。」
因为这句话会让工作范围快速扩张。
一篇 Release Note 里可能有:
10 个链接。
每一页再出现:
20 个相关页面。
Agent 如果把:
「我要尽可能完整」
理解成:
「看到链接就追」,
20 个来源很快就可能变成数百甚至数千次请求。
所以第一个控制是:
AI 只能去哪里。
第二层:每个来源都要有 Request Budget
接着不要只设置:
多久跑一次。
还要替每个来源设置:
最多可以抓多少。
例如这个假设案例可以先测:
每个来源每轮最多读 5 个页面。
20 个来源,
整轮最多:
100 次 Fetch。
这不是网络上的通用标准。
也不是代表:
「100 次一定安全。」
它只是:
团队自己替这条工作流设置的硬上限。
真正可以接受的 Request Rate,
要依每个网站:
Terms、
robots 规则、
官方 API 文档、
Rate Limit
分别决定。
重点不是数字一定是多少。
重点是:
一定要有数字。
为什么不能只说「不要抓太多」?
因为对 Agent 来说:
「太多」
没有明确终点。
但:
「这一轮最多 100 次」
有。
所以正式工作流里,
不要只写:
「请合理使用网站。」
改成可以被程序判断的条件。
例如:
来源最多 20 个。
每站最多 5 个页面。
同一 URL 这轮不重复 Fetch。
已经有 Snapshot 就优先比对。
超过 Budget:
停止,不自己提高上限。
这才是真正的 Control。
第三层:遇到 429,不是叫 Agent 想办法绕过去
HTTP 429 代表:
Too Many Requests。
简单讲:
网站正在告诉你:
「你现在送太多了。」
这时最危险的 Agent 指令是:
「无论如何把工作完成。」
因为 AI 很可能开始想:
换 Endpoint?
换方式抓?
改用其他 Proxy?
重新开连接?
过一秒再试?
但站在对方网站角度,
信号其实已经很清楚:
慢下来。
所以流程可以直接定义:
遇到 429 →
读取 Retry-After →
等待 →
依规则重试。
如果连续超过设置次数仍失败:
停。
不要叫 Agent 继续想其他方法。
503 也一样值得停下来
503 通常代表:
Service Unavailable。
可能是系统暂时无法处理。
这时 Agent 最不该做的是:
因为失败,
反而把重试频率提高。
比较合理的是:
Backoff。
第一次等一下。
还失败,
等更久。
到达重试上限:
留下一笔「这次没有取得数据」的纪录。
这比:
「一定要把数据拿回来」
成熟很多。
因为市场研究里:
今天少一个来源,通常比把别人的网站压垮安全。
Proof:Wikimedia 最近真的看到这种问题
这不是只有理论上的:
「Agent 可能会送太多 Request。」
Wikimedia Foundation 10 月 5 日公布调查。
它表示,
疑似来自 OpenAI Agents 的活动,
曾对 Wikimedia 公开 API 发出:
数百万次自动请求。
还抓取:
数百万个页面。
并对 Wikidata Query Service 发出:
数十万次查找。
Wikimedia 认为,
这些流量:
可能促成今年 5 月一次 Wikidata Query Service 部分中断。
注意:
是「可能」。
Wikimedia 并没有说已百分之百证明:
整次 Outage 完全由 OpenAI Agents 造成。
但这个事件已经足以说明:
Agent 没有偷数据,也可能因为规模造成真实成本。
Wikimedia 本来就有告诉 Bot 怎么正常使用
Wikimedia 的官方 API 文档现在明确要求:
自动化 Client 应该可以被辨识。
例如带上有意义的:
User-Agent。
里面可以包含:
工具名称、
版本、
联系方式。
原因很简单:
如果你的 Bot 出问题,
网站管理者至少知道:
这是谁的程序。
而不是看到一大堆不知道从哪里来的流量。
它甚至明确限制 Concurrent Requests
Wikimedia 2026 年的新 API Rate Limit 文档,
建议 Client:
Concurrent Requests 不超过 3。
也要求:
收到 429 Too Many Requests 时,
遵守:
Retry-After。
这个「3」是 Wikimedia 自己目前的规则,
不是全网通用数字。
其他网站可能是:
1、
10、
100,
甚至根本不允许自动抓取。
所以不要把:
「Wikimedia 可以 3」
变成:
「我的 Agent 到哪里都开 3 个平行 Request。」
真正要做的是:
每个来源读自己的规则。
如果有官方 API,优先用 API
这也是小团队最值得创建的一条规则。
Agent 想要数据时,
顺序可以先设成:
官方 API →
RSS/Feed →
官方 Bulk Download →
一般网页。
而不是:
一律开 Browser 去把页面全部重新读一次。
因为 API 通常更容易知道:
Rate Limit、
数据格式、
授权、
错误回应。
例如 Wikimedia 自己甚至提醒:
大量数据需求不一定适合一直用 Action API,
有些情况应该直接用官方 Bulk Data。
这其实就是很典型的:
不要因为 Agent 会点网页,就所有数据都叫它用网页拿。
如果网站明确说不要呢?
那就不要。
这个案例最重要的 Boundary 就在这里。
网站内容:
公开可看,
不代表:
任何自动化方式、
任何频率、
任何商业用途
都自动被允许。
正式上线前至少要确认:
Terms of Service。
robots/Bot Policy。
API Policy。
数据 License。
Rate Limit。
如果来源不允许自动访问,
Agent 不应该把:
「换个方法抓到」
当成成功。
应该把:
「这个来源需要人工处理」
视为正确结果。
那人还需要做什么?
这个工作流并不是:
AI 每天自己研究完,
老板什么都不用看。
比较合理的分工是:
AI 负责
固定时间检查。
比对昨天与今天。
删掉没有变化的页面。
把真正变更整理成清单。
附来源。
记录抓取失败。
人负责
判断变化是否真的重要。
确认数字与条款。
决定是否通知客户。
做竞争策略解读。
决定要不要增加新的来源。
尤其:
不要让 Agent 自己看到新网站后,就永久把它加入监控。
Source Allowlist 的改动,
由人批准。
这套流程真正要看的 KPI 也不是「Agent 抓了多少页」
如果只是看:
Fetch 数量,
愈多看起来愈努力。
但真正的工作目标其实是:
分析师有没有更快找到值得看的变化。
所以这个假设团队比较适合追:
每天产生多少「真正变更」。
有多少变更最后被分析师判定有价值。
人工还需要花多久确认。
漏掉多少重要更新。
错报多少次。
以及:
有没有发生 Rate-limit/Block/异常流量。
真正成功不是:
AI 抓了 10 万页。
而是:
用合理成本与合理外部负担,抓到真正需要看的 10 件事。
一个可以直接拿走的工作流
如果你明天就要开始测,
先不要做复杂系统。
只写四件事。
1. 来源
这次允许查哪些网站/API?
2. Request Budget
每站每轮最多多少次?
整个任务最多多少次?
3. Backoff
429/503 出现时怎么等?
最多重试几次?
4. Stop
超过 Budget、
来源禁止自动化、
连续失败,
就停止并交给人。
然后才让 Agent 做:
读取 →
比对 →
摘要 →
回报。
为什么这比「帮我每天追竞品」重要?
因为 AI 工作流程的成熟度,
不是看它能不能完成一次任务。
而是看:
它在每天重复跑 100 次以后,还会不会维持同样的边界。
真正可以进公司的 Agent,
不能只有:
Goal。
还要有:
Budget、
Boundary、
Stop。
Wikimedia 这次事件最值得企业学的,
也正是这一点。
如果你也想知道自己的工作里,哪一步最适合先交给 AI,留言「流程」,我可以先帮你看看从哪一步开始。
推荐阅读
AI 商业案例|2026/08/08:12 人 SaaS 新创怎么用 Inspect AI?客服 Agent 接上 CRM 与帐务前,先测正常、停止与越权
AI 一分钟教学|2026/08/01:让 AI Agent 开始工作前,先写清楚「遇到什么情况必须停」
今日 AI 重点|2026/09/28:OpenAI 最强模型 Tool-use 仍暂停,Agent 曾用 DNS 绕过 Sandbox 网络限制